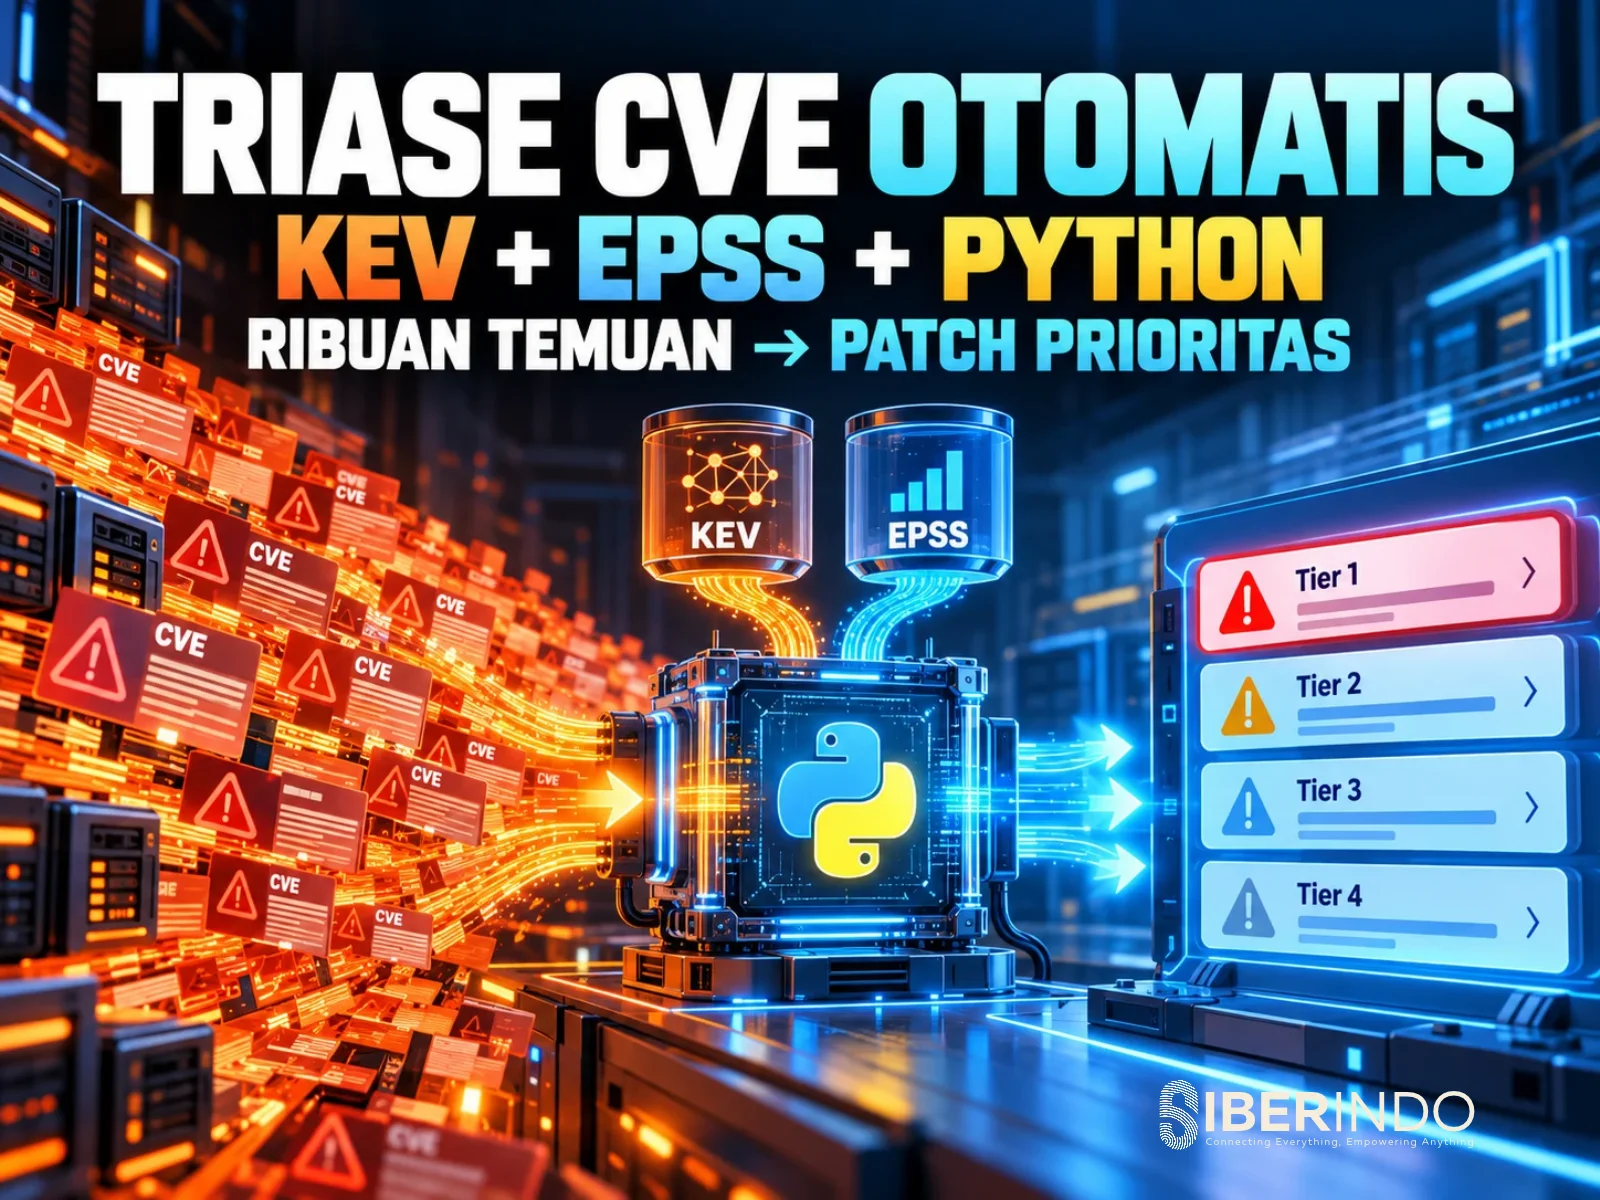
Setiap pekan, tim keamanan dan infrastruktur di Indonesia menerima ratusan hingga ribuan temuan dari pemindai kerentanan. Pada saat yang sama, vendor perangkat edge, aplikasi web, dan sistem operasi terus merilis tambalan, dan sebagian kerentanan sudah dieksploitasi sebelum tambalan tersedia. Pertanyaan yang sebenarnya penting bukan "berapa banyak CVE yang kita punya?", melainkan "CVE mana yang harus ditangani lebih dulu minggu ini?". Tutorial ini menjawabnya dengan membangun skrip Python kecil yang menggabungkan dua sumber data publik: katalog Known Exploited Vulnerabilities (KEV) milik CISA dan skor Exploit Prediction Scoring System (EPSS) milik FIRST.
Mengapa CVSS Saja Tidak Cukup
CVSS mengukur tingkat keparahan teknis suatu kerentanan, bukan seberapa mungkin kerentanan itu benar-benar dipakai penyerang. Akibatnya, daftar yang diurutkan berdasarkan CVSS "Critical" sering kali masih terlalu panjang untuk dikerjakan, sementara kerentanan dengan skor lebih rendah yang sudah dieksploitasi aktif justru terlewat. Beberapa ulasan praktisi di 2026 menyebut bahwa hanya sebagian kecil CVE yang dipublikasikan setiap tahun pernah terlihat dieksploitasi di dunia nyata (angka yang sering dikutip sekitar 4%), sehingga sebagian besar temuan pemindai tidak memiliki bukti ancaman nyata. Angka ini berasal dari sumber sekunder dan bisa berbeda antar-dataset, tetapi arah kesimpulannya konsisten: prioritisasi berbasis bukti eksploitasi jauh lebih efisien daripada prioritisasi berbasis skor keparahan semata.
Dua sinyal yang saling melengkapi dipakai di sini:
- CISA KEV: daftar CVE yang menurut CISA sudah terbukti dieksploitasi di dunia nyata. Setiap entri memuat tanggal penambahan (
dateAdded), tenggat remediasi untuk instansi federal AS (dueDate), dan penanda apakah kerentanan itu dipakai dalam kampanye ransomware (knownRansomwareCampaignUse). Katalog ini lahir dari Binding Operational Directive 22-01. Mandat tersebut hanya mengikat lembaga federal AS, tetapi katalognya publik dan banyak dipakai organisasi swasta sebagai acuan prioritas. - EPSS: model statistik dari FIRST yang memberi probabilitas (0 sampai 1) bahwa sebuah CVE akan dieksploitasi dalam 30 hari ke depan. Skor EPSS rata-rata sebuah CVE sangat kecil (kisaran 0,002 menurut ulasan praktisi), sehingga ambang 0,10 sudah menempatkan CVE di kelompok teratas.
KEV menjawab "apa yang sudah terjadi", EPSS menjawab "apa yang kemungkinan terjadi berikutnya". Menggabungkan keduanya dengan konteks aset Anda sendiri (apakah terekspos ke internet, seberapa kritis) menghasilkan daftar kerja yang realistis.
Arsitektur Singkat Pipeline
- Inventaris temuan: file CSV berisi aset, CVE, tingkat keterpaparan, dan kekritisan. Bisa diekspor dari pemindai apa pun.
- Pengayaan KEV: unduh feed JSON CISA, cocokkan berdasarkan CVE ID.
- Pengayaan EPSS: panggil API FIRST secara batch untuk CVE yang ada di inventaris.
- Penentuan tier: terapkan aturan keputusan yang eksplisit dan dapat diaudit.
- Keluaran: CSV terurut berdasarkan tier dan tenggat internal.
Langkah 1: Menyiapkan Lingkungan dan Data Masukan
Anda hanya memerlukan Python 3.10 ke atas dan pustaka requests.
python -m venv .venv
source .venv/bin/activate
pip install requests
Buat file temuan.csv dengan kolom berikut. Kolom exposure bernilai internet atau internal, dan criticality bernilai high atau normal:
asset,cve,exposure,criticality
mail-gw-01,CVE-2026-104286,internet,high
web-shop-02,CVE-2026-94545,internet,high
hr-app-01,CVE-2025-12345,internal,normal
Nilai CVE di atas hanyalah contoh format; ganti dengan keluaran pemindai Anda.
Langkah 2: Mengunduh Katalog KEV
CISA menyediakan feed JSON publik. Fungsi berikut memuatnya menjadi kamus berkunci CVE ID agar pencarian berlangsung cepat.
import csv
import requests
from datetime import date
KEV_URL = ("https://www.cisa.gov/sites/default/files/feeds/"
"known_exploited_vulnerabilities.json")
EPSS_URL = "https://api.first.org/data/v1/epss"
def muat_kev() -> dict:
r = requests.get(KEV_URL, timeout=30)
r.raise_for_status()
data = r.json()
return {v["cveID"]: v for v in data["vulnerabilities"]}
Setiap entri memiliki dateAdded, dueDate, dan knownRansomwareCampaignUse (bernilai "Known" atau "Unknown"). Kita akan memakai yang terakhir sebagai pemercepat prioritas.
Langkah 3: Mengambil Skor EPSS Secara Batch
API EPSS menerima beberapa CVE sekaligus dalam parameter cve yang dipisahkan koma. Agar URL tidak terlalu panjang, kita memecahnya menjadi potongan kecil. Respons berisi daftar data dengan kolom cve, epss, dan percentile (nilai berupa string, jadi dikonversi ke float).
def muat_epss(daftar_cve: list[str], ukuran: int = 50) -> dict:
hasil = {}
unik = sorted(set(daftar_cve))
for i in range(0, len(unik), ukuran):
potongan = unik[i:i + ukuran]
r = requests.get(EPSS_URL,
params={"cve": ",".join(potongan)},
timeout=30)
r.raise_for_status()
for baris in r.json().get("data", []):
hasil[baris["cve"]] = {
"epss": float(baris["epss"]),
"persentil": float(baris["percentile"]),
}
return hasil
Catatan penting: CVE yang sangat baru mungkin belum memiliki skor EPSS. Fungsi di atas tidak memasukkannya ke kamus, dan pada langkah berikutnya kita memperlakukannya sebagai nol sambil menandainya agar tidak disalahartikan sebagai "aman".
Langkah 4: Aturan Keputusan yang Eksplisit
Inti dari triase adalah aturan yang bisa dijelaskan kepada auditor dan manajemen. Tier di bawah ini mengadaptasi pola yang umum dipakai praktisi (KEV sebagai pemicu utama, ambang EPSS 0,10 dan 0,50, serta pembeda keterpaparan). Angka SLA hanyalah titik awal; sesuaikan dengan kebijakan manajemen risiko dan kapasitas tim Anda.
def tentukan_tier(kev: dict | None, epss: float,
exposure: str, criticality: str) -> tuple[int, int, str]:
"""Mengembalikan (tier, sla_hari, alasan)."""
terekspos = exposure == "internet"
kritis = criticality == "high"
ransomware = bool(kev) and kev.get("knownRansomwareCampaignUse") == "Known"
if kev and (terekspos or kritis):
if ransomware:
return 1, 1, "KEV + dipakai ransomware + terekspos/kritis"
return 1, 3, "KEV + terekspos/kritis"
if epss >= 0.50 and terekspos and kritis:
return 1, 3, "EPSS tinggi + terekspos + aset kritis"
if kev:
return 2, 14, "KEV pada aset internal non-kritis"
if epss >= 0.10 and terekspos:
return 2, 7, "EPSS >= 0,10 + terekspos"
if epss >= 0.10:
return 3, 30, "EPSS >= 0,10, tidak terekspos"
return 4, 90, "Pantau: tidak ada bukti eksploitasi"
Perhatikan bahwa semua kerentanan KEV tetap masuk antrean prioritas, bahkan pada aset internal. Alasannya sederhana: kerentanan yang sudah terbukti dieksploitasi sering dipakai untuk pergerakan lateral setelah penyerang menembus perimeter.
Langkah 5: Menyatukan Semuanya
def proses(berkas_masuk: str, berkas_keluar: str) -> None:
with open(berkas_masuk, newline="", encoding="utf-8") as f:
temuan = list(csv.DictReader(f))
kev = muat_kev()
epss = muat_epss([t["cve"] for t in temuan])
baris_keluar = []
for t in temuan:
cve = t["cve"].strip().upper()
skor = epss.get(cve)
tier, sla, alasan = tentukan_tier(
kev.get(cve),
skor["epss"] if skor else 0.0,
t["exposure"], t["criticality"],
)
baris_keluar.append({
"tier": tier, "sla_hari": sla, "asset": t["asset"],
"cve": cve, "di_kev": cve in kev,
"epss": skor["epss"] if skor else "",
"epss_tersedia": bool(skor),
"tenggat_kev": kev.get(cve, {}).get("dueDate", ""),
"alasan": alasan,
})
baris_keluar.sort(key=lambda b: (b["tier"], b["sla_hari"]))
with open(berkas_keluar, "w", newline="", encoding="utf-8") as f:
w = csv.DictWriter(f, fieldnames=baris_keluar[0].keys())
w.writeheader()
w.writerows(baris_keluar)
print(f"{len(baris_keluar)} temuan diproses pada {date.today()}")
if __name__ == "__main__":
proses("temuan.csv", "prioritas_patch.csv")
Jalankan dengan python triase.py. Hasilnya adalah prioritas_patch.csv yang sudah terurut: tier 1 di bagian atas, lengkap dengan alasan keputusan sehingga setiap baris dapat dipertanggungjawabkan.
Langkah 6: Menjadwalkan dan Mengintegrasikan
Skrip ini baru bernilai jika dijalankan rutin. Beberapa praktik yang kami sarankan:
- Jadwalkan harian lewat cron atau pipeline CI, karena KEV diperbarui hampir setiap hari kerja dan CVE baru bisa langsung masuk katalog.
- Kirim notifikasi hanya untuk tier 1 ke kanal tim (email atau chat) agar tidak menimbulkan kelelahan peringatan.
- Simpan riwayat keluaran untuk mengukur metrik seperti waktu rata-rata remediasi per tier, yang berguna sebagai bukti tata kelola.
- Tambahkan fallback: bila feed KEV atau API EPSS tidak dapat diakses, skrip harus gagal dengan jelas, bukan diam-diam menghasilkan daftar yang tampak aman.
- Cache feed secara lokal dan hormati batas wajar pemanggilan API publik.
Keterbatasan yang Perlu Dipahami
Pendekatan ini kuat, tetapi bukan peluru perak. Pertama, KEV hanya memuat eksploitasi yang terdokumentasi dan diverifikasi CISA, sehingga kerentanan yang dieksploitasi secara terbatas atau di produk yang kurang dikenal di Amerika Serikat bisa belum tercantum. Kedua, EPSS adalah probabilitas statistik berbasis data global; produk yang populer di Indonesia namun jarang terpantau di dataset global bisa terwakili kurang akurat. Ketiga, kedua sumber tidak tahu konfigurasi Anda: kerentanan pada layanan yang tidak terekspos dan sudah dibatasi segmentasi jaringan mungkin risikonya jauh lebih rendah daripada yang tersirat. Karena itu, keputusan akhir tetap membutuhkan analis manusia, terutama untuk aset berdampak tinggi. Untuk kerentanan yang belum memiliki tambalan, catat kontrol kompensasi (nonaktifkan fitur rentan, batasi akses manajemen, tambah pemantauan) sebagai bagian dari keluaran, bukan menunggu patch.
Rambu Hukum dan Tata Kelola di Indonesia
Prioritisasi patch bukan sekadar urusan teknis. Pasal 35 UU PDP No. 27/2022 mewajibkan pengendali data pribadi menjaga keamanan data pribadi, dan Pasal 46 mewajibkan pemberitahuan tertulis dalam waktu paling lambat 3x24 jam bila terjadi kegagalan pelindungan data pribadi. Kerentanan yang sudah masuk KEV dan dibiarkan tak ditambal pada sistem yang menyimpan data pelanggan akan sulit dibela sebagai "upaya yang wajar" ketika terjadi insiden. Dengan tenggat kepatuhan PP 33/2026 pada 16 Januari 2027, dokumentasi proses triase seperti keluaran skrip ini (siapa memutuskan apa, kapan, dan atas dasar apa) menjadi bukti akuntabilitas yang bernilai. Dari sisi kerangka kerja, pendekatan ini sejalan dengan prinsip manajemen kerentanan dalam NIST Cybersecurity Framework dan kontrol manajemen kerentanan teknis pada ISO/IEC 27001:2022 (kontrol 8.8).
Satu catatan etika: skrip ini hanya memproses data inventaris milik organisasi Anda sendiri dan dua sumber data publik. Jangan menggunakannya, atau data KEV, untuk memindai atau menguji sistem pihak lain tanpa izin tertulis; tindakan tersebut dapat melanggar Pasal 30 UU ITE tentang akses ilegal.
Penutup
Triase kerentanan yang baik adalah soal menjawab pertanyaan yang tepat: apa yang sudah dieksploitasi, apa yang kemungkinan besar dieksploitasi berikutnya, dan seberapa besar dampaknya pada aset kita. Dengan kurang dari seratus baris Python, Anda sudah dapat mengubah ribuan temuan menjadi daftar kerja yang transparan dan dapat diaudit. Dari sini, pengembangan lanjutan yang masuk akal antara lain menautkan hasil ke sistem tiket, memperkaya konteks dengan data kepemilikan aset, dan melaporkan metrik remediasi ke manajemen. Tim Siberindo siap membantu organisasi Anda merancang program manajemen kerentanan yang terukur, mulai dari inventaris aset, otomatisasi triase, hingga kesiapan respons insiden sesuai UU PDP.
Sumber rujukan: katalog CISA Known Exploited Vulnerabilities (cisa.gov), dokumentasi EPSS FIRST (first.org/epss), serta ulasan praktisi Decryption Digest tentang otomatisasi prioritisasi patch dan proses triase CVE 2026. Angka statistik dari ulasan praktisi bersifat indikatif.